
在 RAG 架構中,檢索品質直接決定了最終產出的上限。若是 Embedding 模型無法精準捕捉程式碼語法與技術名詞的語義,或者排序雜亂,注入給 LLM 的上下文就會充滿雜訊,導致嚴重幻覺。
今天我們將完成第一週基礎建設的最後一塊拼圖:評估技術文件專用的 Embedding 模型,並在本地部署 Cross-Encoder Reranker 服務,形成「初篩(Retrieval)+ 精排(Rerank)」的高精準檢索體系。
在中台設計中,我們採用兩階段檢索策略:
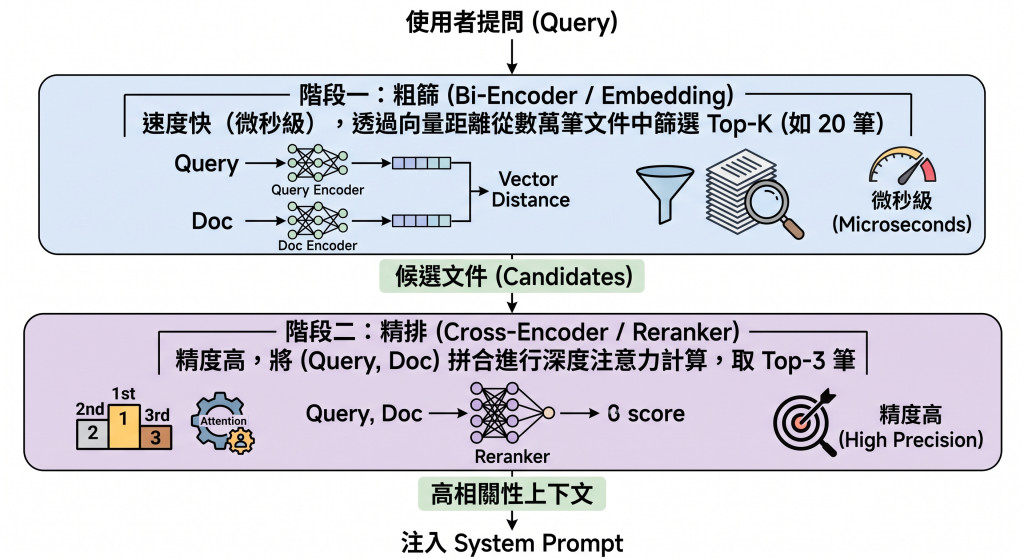
BAAI/bge-large-zh-v1.5(1024 維)。在中文語意與技術詞彙表徵具備極高水準,完美對應 Day 06 Qdrant 設定的 1024 維度。BAAI/bge-reranker-large。支援中英文混合代碼文件,推論開銷適中,可在 CPU 或低階 GPU 順暢運作。pip install sentence-transformers torch
建立 retrieval_engine.py,封裝 Embedding 生成與 Rerank 計算邏輯:
import torch
from sentence_transformers import SentenceTransformer, CrossEncoder
from typing import List, Dict, Tuple

class RetrievalEngine:
    def __init__(
        self,
        embedding_model_name: str = "BAAI/bge-large-zh-v1.5",
        reranker_model_name: str = "BAAI/bge-reranker-large",
        device: str = None
    ):
        if device is None:
            self.device = "cuda" if torch.cuda.is_available() else "cpu"
        else:
            self.device = device

        print(f"正在載入模型至運算裝置: {self.device}...")

        # 載入 Embedding 模型 (Bi-Encoder)
        self.embedding_model = SentenceTransformer(
            embedding_model_name,
            device=self.device
        )

        # 載入 Reranker 模型 (Cross-Encoder)
        self.reranker_model = CrossEncoder(
            reranker_model_name,
            device=self.device
        )
        print("檢索與重排模型初始化完成!")

    def encode_queries(self, queries: List[str]) -> List[List[float]]:
        """針對提問進行向量化(BGE 規範建議針對 Query 加上提示前綴以提升檢索率)"""
        # BGE 中文模型官方建議前綴
        instruction = "為這個句子生成表示以用於檢索相關文章:"
        formatted_queries = [f"{instruction}{q}" for q in queries]
        embeddings = self.embedding_model.encode(
            formatted_queries,
            normalize_embeddings=True,
            show_progress_bar=False
        )
        return embeddings.tolist()

    def encode_documents(self, docs: List[str]) -> List[List[float]]:
        """針對規範文本切割塊進行向量化(Document 端無須加前綴)"""
        embeddings = self.embedding_model.encode(
            docs,
            normalize_embeddings=True,
            show_progress_bar=False
        )
        return embeddings.tolist()

    def rerank(
        self,
        query: str,
        documents: List[Dict],
        top_k: int = 3
    ) -> List[Tuple[Dict, float]]:
        """
        將候選文件進行精準二次排序
        documents 格式範例: [{"id": 1, "content": "..."}]
        """
        if not documents:
            return []

        # 組裝 (Query, Doc_Content) 對
        pairs = [[query, doc["content"]] for doc in documents]

        # Cross-Encoder 評分計算
        scores = self.reranker_model.predict(pairs)

        # 綁定評分並依相關度降序排列
        scored_docs = list(zip(documents, scores))
        scored_docs.sort(key=lambda x: x[1], reverse=True)

        return scored_docs[:top_k]
撰寫 verify_retrieval.py 測試粗篩與精排的排序表現:
from retrieval_engine import RetrievalEngine

engine = RetrievalEngine()

# 模擬粗篩階段從向量資料庫撈取到的 4 筆候選文件
candidate_docs = [
    {
        "id": "SEC-01",
        "title": "資料庫連線字串管理規章",
        "content": "生產環境資料庫密碼必須使用 HashiCorp Vault 託管,嚴禁明文寫入程式碼或設定檔。"
    },
    {
        "id": "REST-01",
        "title": "API 資源命名設計準則",
        "content": "所有對外端點路徑必須採用複數小寫名詞(如 /v1/orders),並嚴格禁止在 URI 出現動詞。"
    },
    {
        "id": "GIT-01",
        "title": "Git Commit 命名風格指南",
        "content": "提交訊息必須遵循 Conventional Commits 格式,包含 feat, fix, chore 等標籤前綴。"
    },
    {
        "id": "SEC-02",
        "title": "機敏 Token 與金鑰防護規範",
        "content": "第三方服務 API Key 不可直接 Commit 至 Git 倉庫,開發人員應統一使用內部環境變數加解密工具注入。"
    }
]

# 模擬工程師提問
user_query = "請問我寫程式時,第三方金鑰跟 API Token 應該怎麼存?"

print(f"使用者提問: {user_query}\n")

# 執行精確二次重排序
top_results = engine.rerank(user_query, candidate_docs, top_k=2)

print("--- Rerank 精選前兩名規範 ---")
for rank, (doc, score) in enumerate(top_results, start=1):
    print(f"[Top {rank}] 得分: {score:.4f} | 標題: {doc['title']}")
    print(f"內容: {doc['content']}\n")
執行後可發現,儘管 SEC-01 同樣涉及密碼安全,但 Reranker 能精確辨析 SEC-02 的文字語意更直接契合問題中的「第三方金鑰」與「API Token」,並將其賦予最高的置信度分數。
向量歸一化(Normalize Embeddings):
記憶體管理與載入延遲:
至此,第一週的基礎架構已經全部完成:
Day 01 - Day 02:確刻架構拓撲與中台藍圖。
Day 03 - Day 05:打通地端/雲端推論管線並架設好 API Gateway 骨架。
Day 06 - Day 07:完成 Qdrant 向量資料庫與本地檢索/重排雙階段引擎。
下週我們將正式邁入模組二:開發規範 RAG 知識庫管線。明天 Day 08 將處理真實企業開發規範的文件預處理:解析 Markdown、Git Flow 與 OpenAPI Schema,清洗噪音並建立結構化 Metadata。


 iThome鐵人賽
 看影片追技術